Google показывает японские заголовки, рекламу казино и неизвестные страницы, хотя сайт выглядит обычным. Разбираем, как выявить скрытый SEO-спам, найти источник подмены и очистить поисковую выдачу без потери нужных страниц.
website security check
Что проверить в первую очередь
Начните с конкретных адресов. Скриншот странной выдачи полезен, но для расследования нужны URL, условия появления результата и время проверки. Если спам открывается только после перехода из поиска, сохраните исходный адрес страницы и конечный адрес перенаправления.
- 01Зафиксируйте примеры. Скопируйте несколько подозрительных URL из разных групп: главная с чужим заголовком, новый раздел, адрес с параметрами, страница с редиректом. Сохраните запрос и дату наблюдения.
- 02Посмотрите сведения Google. В Search Console проверьте каждый адрес, статус индексации и дату последнего обхода. Не смешивайте эти данные с результатом новой проверки опубликованной страницы.
- 03Получите текущий ответ. Откройте страницу без авторизации и сохраните её HTTP-статус, заголовки и HTML. Зафиксируйте, меняется ли поведение при другом устройстве или способе перехода.
- 04Сохраните материалы до очистки. Сделайте копию файлов и базы, выгрузите доступные журналы, текущие карты сайта и список подозрительных адресов. Копию храните вне общедоступного каталога сайта.
- 05Проверьте доступы. Посмотрите, кто управляет CMS, хостингом и Search Console. Незнакомые учётные записи сначала сопоставьте с сотрудниками и подрядчиками.
Если посетители прямо сейчас попадают на опасный ресурс, ограничивайте заражённый маршрут вместе с администратором. Сохранение доказательств не должно затягивать прекращение опасной выдачи. При этом блокировка всего сайта без разбора может затронуть рабочие страницы и затруднить дальнейшие проверки.
Как проявляется скрытый SEO-спам
При таком заражении злоумышленник использует сайт для размещения постороннего контента: создаёт новые страницы, внедряет ссылки и тексты в существующие, меняет метаданные или перенаправляет посетителей. Японский спам — один из вариантов. Та же схема может использовать рекламу азартных игр, лекарств, поддельных товаров или финансовых предложений.
Клоакинг — подмена содержимого в зависимости от того, кто и при каких условиях запрашивает страницу. Владелец видит обычный сайт, а поисковый робот или посетитель из выдачи получает другой ответ. При этом не всякое различие является взломом: язык, авторизация, версия для телефона и штатная персонализация тоже могут менять страницу.
| Что заметили | Что это может означать | Чем проверить |
|---|---|---|
| В выдаче чужой текст, в браузере всё нормально | Условная подмена либо старые сведения Google | Сравнить даты, доступный HTML последнего обхода и текущие ответы |
| Появились сотни неизвестных адресов | Генератор спама, ошибка маршрутизации или параметры, создающие дубли | Выбрать адреса из разных групп и проверить их содержимое и статус |
| Страница отсутствует в админке | Ответ создаётся вне обычного списка записей CMS | Проверить маршруты, шаблоны, конфигурацию и источник данных |
| Редирект возникает только при некоторых переходах | Условный обработчик на сервере или в браузере | Сохранить цепочку переходов и сопоставить условия запросов |
| Поисковый заголовок отличается от заголовка страницы | Изменённые метаданные, старая версия или автоматическая переработка заголовка поисковиком | Сверить title, основной текст и сведения об обходе |
| Search Console знает адрес, которого вы не создавали | URL обнаружен, но не обязательно проиндексирован | Проверить состояние именно этого URL, а не делать вывод по одному списку |
Посторонняя страница на другом домене — отдельная ситуация. Копирование вашего текста ещё не доказывает заражение вашего сервера. Сначала убедитесь, что результат действительно относится к вашему домену или поддомену, и проверьте заявленный canonical — адрес предпочтительной версии страницы.
Почему чужих страниц нет в админке сайта
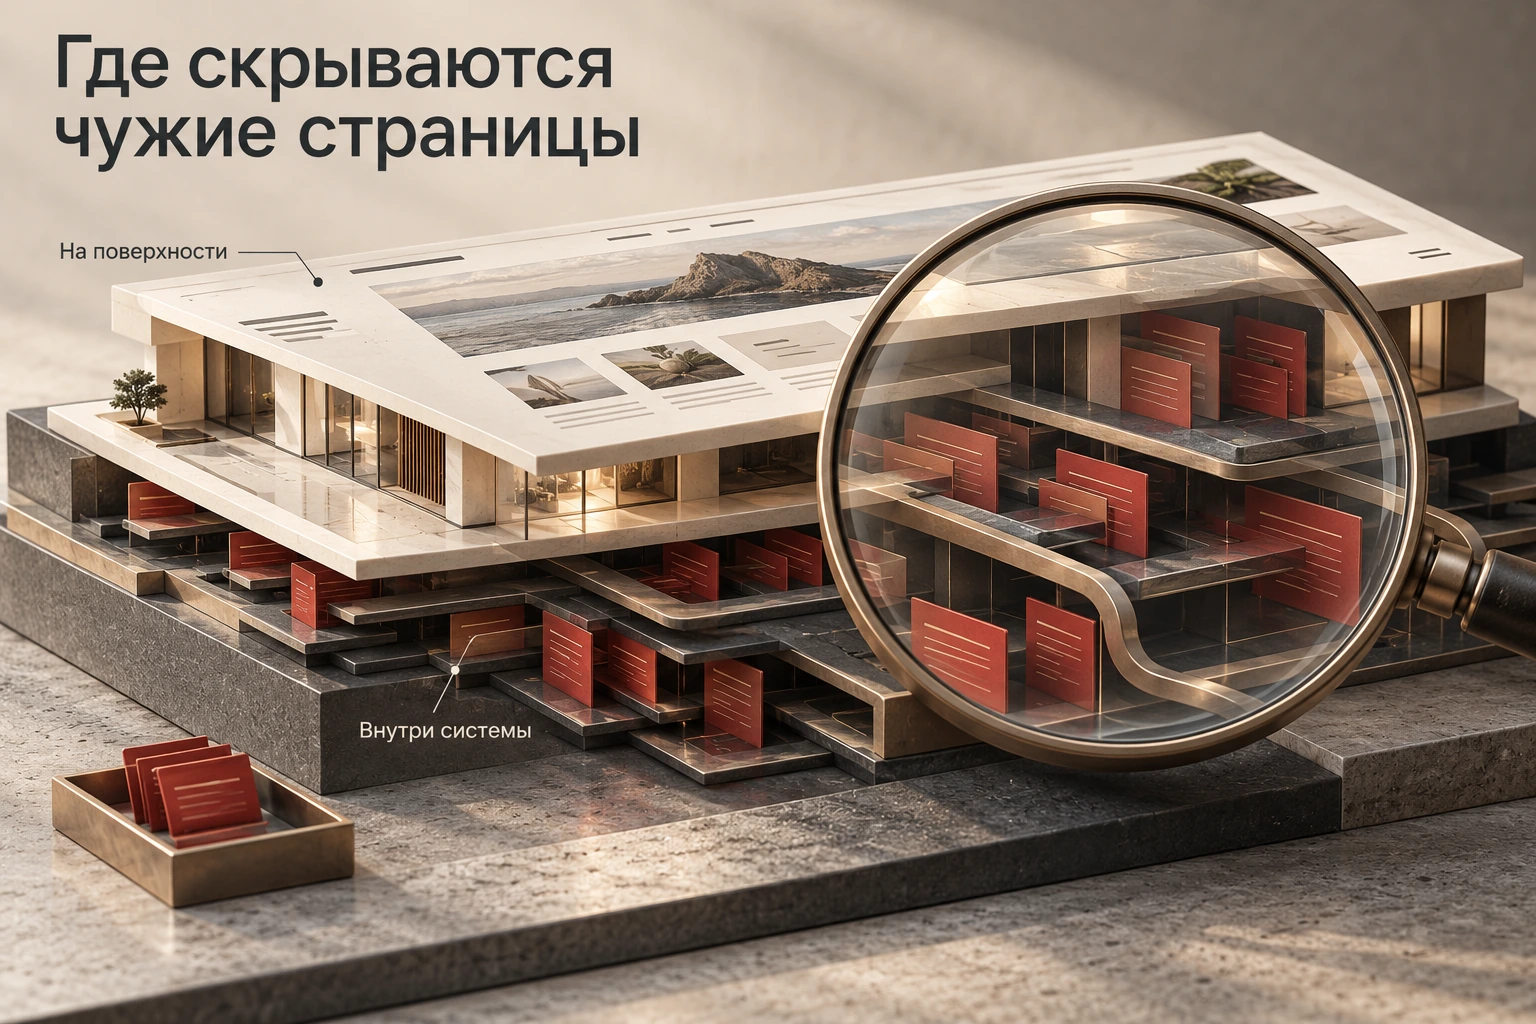
Адрес в интернете не обязан соответствовать отдельному файлу или записи WordPress. Один обработчик может отвечать на множество URL и формировать содержимое во время запроса. Поэтому поиск по списку страниц CMS охватывает только часть возможных источников.
Где появляется постороннее содержимое
- В существующих записях и настройках. Спам может находиться в тексте, метаполях, виджетах, блоках, меню или настройках расширения.
- В общих файлах. Изменённый шаблон, подключаемый файл или точка входа влияет сразу на множество страниц.
- В маршрутах и конфигурации. Правила сервера или CMS направляют неизвестные адреса к постороннему обработчику.
- Во внешнем источнике. Код получает чужой контент по сети и подставляет его в ответ. Самого рекламного текста в локальных файлах может не оказаться.
- В кеше или промежуточном слое. Разные версии могут сохраняться на сервере, в расширении кеширования либо в CDN. Это нужно проверять вместе с местом первоначального изменения.
Что проверить в WordPress
Сопоставьте файлы ядра с официальным пакетом той же версии и локализации. Отдельно проверьте активную тему, плагины, автоматически загружаемые расширения в wp-content/mu-plugins, каталог загрузок, wp-config.php, точку входа и серверные правила. В базе проверьте содержимое записей, метаполей и настроек. Имена таблиц зависят от используемого префикса.
Следующие команды предназначены для администратора, работающего в каталоге проверяемой копии сайта. Они формируют результаты проверки и ничего не удаляют. Команда поиска по содержимому рассчитана на GNU grep.
find wp-content/uploads -type f \( -iname '*.php' -o -iname '*.phtml' -o -iname '*.phar' \) -printНайденный файл требует проверки назначения, содержимого и происхождения. Расширение и расположение — признаки для отбора, а не достаточное основание для удаления.
grep -rInE --include='*.php' --include='*.phtml' -- \
  '(eval|base64_decode|gzinflate|shell_exec|assert|str_rot13)[[:space:]]*\(' \
  wp-content
Совпадение может относиться к легитимному коду. Отсутствие совпадений тоже не означает, что заражения нет: код может использовать другие функции, расширения и способы подключения. Ошибки доступа к файлам необходимо учитывать, иначе просмотр окажется неполным.
wp core verify-checksums --include-rootПроверка контрольных сумм ядра выполняется до загрузки WordPress. Она не проверяет всю базу, тему, плагины и внешнюю инфраструктуру. Предупреждение о стороннем файле в корне также не равно обнаружению вируса. Не запускайте найденный подозрительный PHP-файл для проверки его поведения.
Как собрать список подозрительных URL
Соберите адреса из нескольких источников: поисковой выдачи, отчётов Search Console, карт сайта, внутренних ссылок и серверных журналов. Это рабочий перечень найденных URL, а не автоматически полный масштаб заражения. Один генератор способен создавать адреса, которые пока не встретились ни в одной выгрузке.
Поиск site:ваш-домен с подозрительным словом помогает обнаружить примеры. Но оператор site: не показывает все проиндексированные страницы, а приблизительное число результатов нельзя использовать как точный счётчик спама.
В Search Console смотрите отчёты об индексации страниц, эффективности и файлах Sitemap. Необычные поисковые запросы дают дополнительную зацепку, однако отсутствие показов не исключает наличие постороннего содержимого. Проверьте также неожиданные поддомены и версии адресов, если они относятся к вашей инфраструктуре.
Как сгруппировать адреса для проверки
- Сохраните исходные URL целиком, включая параметры. Сразу не обрезайте их: условие подмены может зависеть от строки запроса.
- Разделите адреса по общему пути, параметрам, языку, шаблону содержимого и поведению.
- Из каждой группы возьмите несколько представителей, включая адреса с разными ответами.
- Добавьте обычные рабочие страницы как контрольную группу: главную, услугу, товар или статью.
- Отдельно отмечайте найденные, проиндексированные и доступные сейчас адреса. Это разные состояния.
Если сотни неизвестных URL возвращают одну и ту же чистую главную страницу со статусом 200, проверьте обработку несуществующих адресов. Это может быть ошибка маршрутизации. Для вывода о SEO-спаме нужно установить наличие постороннего содержимого или несанкционированного механизма его выдачи.
Как сравнить то, что видит Google и получает посетитель
Сравнивайте один и тот же URL и записывайте время каждого наблюдения. Если адрес, параметры или дата различаются, можно принять разные состояния страницы за одновременную подмену.
Последний обход и новая проверка страницы
В инструменте проверки URL сначала изучите сведения о сохранённой версии: статус индексации, время последнего обхода и доступные данные просканированной страницы. Затем отдельно запустите проверку опубликованной страницы и посмотрите доступный HTML, снимок и сведения о загрузке ресурсов.
Проверку опубликованной страницы выполняет Google-InspectionTool. Это отдельный тип обращения, поэтому результат не воспроизводит все условия предыдущего обхода Googlebot. Успешная проверка доступности также не гарантирует индексацию и не является полной проверкой безопасности сайта.
Зафиксируйте различия в основном тексте, заголовке, ссылках, canonical и перенаправлениях. Если спам содержится только в старых данных, сравните дату их получения с датой исправления. Если он появляется в свежем ответе, расследуйте действующую подмену или сохранившуюся заражённую версию в кеше.
Как сохранить текущий HTTP-ответ
Администратор может получить два ответа через curl, изменив только User-Agent — строку, которой клиент представляется серверу. Замените адрес в переменной на проверяемую страницу своего сайта. Запускайте команды в отдельном рабочем каталоге вне публичной папки сайта: там сохранятся заголовки и HTML.
page_url='https://example.com/podozritelnyj-adres/'
check_dir="seo-check-$(date -u +%Y%m%dT%H%M%SZ)"
mkdir -p "$check_dir"
date -u +'%Y-%m-%dT%H:%M:%SZ' > "$check_dir/time.txt"

curl --silent --show-error --compressed \
  --connect-timeout 10 --max-time 30 \
  --user-agent 'Mozilla/5.0' \
  --dump-header "$check_dir/browser.headers.txt" \
  --output "$check_dir/browser.html" \
  --write-out 'Обычный запрос: HTTP %{http_code}\n' \
  "$page_url"

curl --silent --show-error --compressed \
  --connect-timeout 10 --max-time 30 \
  --user-agent 'Googlebot' \
  --dump-header "$check_dir/agent.headers.txt" \
  --output "$check_dir/agent.html" \
  --write-out 'Изменённый User-Agent: HTTP %{http_code}\n' \
  "$page_url"

diff -u -- "$check_dir/browser.html" "$check_dir/agent.html"
Команды сохраняют первый ответ и не переходят автоматически по редиректам. При статусе 3xx проверьте заголовок Location и отдельно зафиксируйте дальнейшую цепочку. Здесь используется GET: проверка только заголовков через HEAD может не воспроизвести выдачу содержимого.
curl не исполняет JavaScript и не воспроизводит все заголовки, cookies и поведение браузера. Сохранённый подозрительный HTML сначала просматривайте как текст. Если curl сообщает ошибку или показывает HTTP 000, полноценный HTTP-ответ не получен; такой результат нельзя считать подтверждением чистоты. У diff код завершения 1 означает найденные различия, а не неисправность самой команды.
Почему смены User-Agent недостаточно
Вредоносный обработчик может учитывать IP, источник перехода, авторизацию, cookies, параметры URL или время обращения. Простая строка Googlebot не делает запрос настоящим визитом Google. Поэтому отрицательная проба с другим User-Agent исключает только проявление подмены в проверенных условиях.
Если исходный HTML чистый, но отображение страницы меняется после загрузки, изучите сетевые запросы и итоговое содержимое в инструментах разработчика браузера. Если ответы расходятся между сервером и CDN, сохраняйте сведения о кеше и времени запроса. Не отключайте всю защиту сайта ради одного теста: сначала выясните, какой слой создаёт различие.
Как найти связь между подменой и событиями в журналах
Журналы позволяют сопоставить обращения к подозрительным URL с изменениями на сайте. Сведите время к одному часовому поясу и проверьте точность часов сервера. Иначе события из разных источников могут оказаться в неверном порядке.
Для выбранного адреса отметьте время запроса, HTTP-метод, статус, объём ответа, User-Agent, IP и источник перехода — в пределах полей, которые действительно записывает ваш журнал. При наличии сопоставьте это с журналами входов, изменениями файлов, заданиями по расписанию и событиями панели хостинга.
grep -F -- '/podozritelnyj-adres/' access.logЭто отбор кандидатов по строке, а не полноценный анализ формата журнала. Проверьте, что совпадение относится именно к запрошенному пути. Учтите журналы за предыдущие периоды, архивы после ротации и обращения с другими параметрами URL.
Как проверить настоящего Googlebot
Строку Googlebot может указать любой клиент. Для обычного поискового робота сопоставьте IP с официальным списком диапазонов этой категории либо выполните обратный DNS-запрос, проверьте допустимое имя и затем прямым DNS-запросом убедитесь, что оно возвращает исходный IP. Для обычных роботов используются имена в googlebot.com, включая geo.googlebot.com; у других категорий правила отличаются.
Проверяйте именно окончание доменного имени и полный цикл подтверждения. Вхождение слова Google в произвольный адрес не подтверждает его владельца. Принадлежность IP облачной инфраструктуре Google тоже не устанавливает, что запрос сделал поисковый робот. За CDN учитывайте только адрес клиента, полученный через доверенную конфигурацию прокси.
Что показало наше расследование повторного редиректа
В одном из случаев, с которым мы работали, сайт перенаправлял посетителей на казино. После удаления обнаруженного кода нормальная работа восстанавливалась, но затем редирект возвращался. Проверка журналов помогла установить, где и когда происходили действия, связанные с повторным появлением проблемы, и завершить очистку.
Для скрытого SEO-спама полезен тот же принцип: связывать изменение ответа с конкретными событиями. При этом сам факт редиректа ещё не доказывает, что Google получал другие страницы. Подробности повторного заражения разбираем в статье почему вирус на WordPress возвращается после удаления.
Какие доступы и карты сайта проверить
Скрытый спам нужно искать не только в содержимом страниц. Проверьте, кто может менять сайт и его поисковую конфигурацию: владельцев и пользователей Search Console, администраторов CMS, доступы к хостингу, SFTP или SSH, репозиторию, DNS и CDN — в зависимости от устройства проекта.
Владельцы Search Console и подтверждение прав
В настройках ресурса откройте список пользователей и разрешений, посмотрите историю владения и оставшиеся токены подтверждения. Сначала выясните, кому принадлежат незнакомые записи: это может быть прежний подрядчик. Доступ к Search Console сам по себе не означает возможность менять файлы сайта, но посторонний подтверждённый владелец требует расследования.
Если доступ несанкционированный, недостаточно убрать пользователя из списка. Проверьте все способы подтверждения его прав: HTML-файл, метатег, DNS-запись либо соответствующие права в Google Analytics и Tag Manager. Оставшийся способ подтверждения может позволить получить доступ повторно.
Удаляйте только подтверждённо посторонние токены. Общий токен может использоваться и другим сервисом. Не стирайте все записи google-site-verification без установления владельца и назначения.
Неожиданные файлы Sitemap
Сравните карты сайта, указанные в Search Console и robots.txt, с теми, которые создаёт штатная CMS или SEO-плагин. Откройте сами файлы и проверьте адреса внутри. Незнакомый sitemap может быть следствием внедрения, а может относиться к легитимному расширению: решающими будут источник генерации и содержимое.
При обнаружении спамной карты сначала сохраните её копию и связанные события. Удаление записи об отправке Sitemap из Search Console не устраняет файл на сервере и не закрывает генератор страниц. После очистки проверьте, что карта не появляется снова.
Отдельно изучите разделы проблем безопасности и мер, принятых вручную. Отсутствие сообщения означает, что в отчёте нет соответствующего обнаружения Google; это не заменяет техническую проверку сайта.
Как убрать подмену и сохранить нужные страницы
Работы должны затронуть источник содержимого, механизм его выдачи и доступ, через который появились изменения. Удаление рекламного текста решает только видимую часть задачи, если обработчик продолжает работать или сохраняется возможность повторной записи.
- 01Установите затронутые компоненты. Сопоставьте ответы URL с файлами, настройками, записями базы и доступными журналами. Зафиксируйте, какие выводы подтверждены, а какие ещё проверяются.
- 02Восстановите содержимое из доверенного источника. Для стандартного компонента используйте соответствующий чистый пакет; собственный код сравнивайте с проверенной версией. Не переносите подозрительные файлы в рабочую сборку вместе с резервной копией.
- 03Устраните обнаруженный путь изменения. Обновите уязвимый компонент, исправьте права или отзовите скомпрометированный доступ. Смену секретов и завершение активных сеансов согласуйте с восстановлением доверенной среды.
- 04Проверьте связанные места. Учётные записи, задания по расписанию, автоматически подключаемые файлы, другие сайты с доступом к тем же данным и инфраструктуру публикации.
- 05Обновите кеш и повторите проверки. После устранения источника убедитесь, что сервер и промежуточные слои больше не отдают прежнюю подменённую версию.
Если точный первоначальный вход установить не удалось из-за отсутствия журналов, это нужно отразить в результате расследования. Нельзя объявлять конкретный плагин причиной только потому, что он давно не обновлялся.
| Тип адреса | Действие | Что проверить после |
|---|---|---|
| Нужная страница с внедрённым спамом | Восстановить её содержимое и сохранить исходный адрес | Ответ 200, правильный текст и метаданные, отсутствие чужих ссылок и редиректов |
| URL создан только для спама | Убрать генератор и связанные данные; вернуть 404 или 410 | Реальный HTTP-статус, отсутствие спама и его повторной генерации |
| Ненужный вариант с параметрами | Разобрать назначение параметров и маршрутизацию; выбрать решение по содержимому | Сохраняются поиск, фильтры, товары и другие легитимные функции |
| Страница действительно переехала | Настроить постоянный редирект на её соответствующую замену | Целевая страница отвечает по смыслу исходной, цепочка не ведёт на посторонний ресурс |
| Доступ перекрывает защитный экран | Проверить правило блокировки и сам источник содержимого | 403 не используется как единственное доказательство удаления вредоносного кода |
Правило для целой папки допустимо только после проверки всех затрагиваемых типов адресов. Внутри внешне подозрительного раздела могут оставаться рабочие страницы. Исправление маршрутов нужно проверять и на контрольной группе обычных URL.
Как убрать последствия взлома из Google
Исправление сайта и обновление поисковой выдачи происходят в разное время. Сначала нужно добиться правильного поведения URL. Затем проверить, что Google получил исправленное состояние. Старый результат в поиске сразу после очистки ещё не доказывает повторного заражения.
Сохранены подозрительные URL и признаки подмены.
Источник устранён, текущие ответы повторно проверены.
Зафиксирован последующий обход и проверено состояние в Google.
404 и 410 для удалённых спамных адресов
Для адреса, который больше не должен существовать, сервер должен возвращать настоящий 404 или 410. Надписи «Страница не найдена» недостаточно, если HTTP-ответ остаётся 200: это может привести к распознаванию soft 404. Для удаления из индекса Google обрабатывает 404 и 410 одинаково; фиксированный выигрыш по срокам обещать нельзя.
Не перенаправляйте тысячи спамных URL на главную. Такой переход не создаёт соответствующей замены удалённому содержимому и затрудняет оценку результата. У рабочей страницы после удаления внедрения должен остаться её нормальный полезный ответ.
Когда использовать временное удаление
Инструмент удаления URL в Search Console позволяет временно скрыть результат примерно на шесть месяцев. Это полезно для срочного ограничения видимости уже установленных спамных страниц, но не очищает сервер и не отменяет необходимость правильных ответов URL.
При удалении по префиксу проверяйте границы правила: оно не должно затронуть каталог с нужными товарами или статьями. Для восстановленной полезной страницы основная задача — дать Google получить чистую версию, а не постоянно держать адрес скрытым.
Почему robots.txt не заменяет удаление
Запрет обхода не гарантирует исключение URL из поиска. Кроме того, если Google не может запросить страницу, он не увидит её новый статус или директиву noindex. Для окончательно удалённого мусорного адреса выбирайте корректный ответ сервера, а для нужной страницы сохраняйте доступность её чистой версии.
Что делать с картой сайта и пересмотром
Уберите спамные URL из внутренних ссылок и Sitemap. Убедитесь, что актуальная карта содержит нужные канонические страницы, и отправьте её в Search Console. Для важных восстановленных адресов можно запросить индексирование, учитывая ограничения инструмента. Не отправляйте удалённые спамные URL как страницы, которые нужно индексировать.
Если Google указал проблему безопасности, после устранения всех обозначенных причин используйте доступный запрос на проверку в соответствующем отчёте. Если есть мера, принятая вручную, работайте с её описанием и процедурой пересмотра отдельно. Отправлять одинаковое обращение «на всякий случай» во все разделы не требуется.
После очистки проверьте не только исчезновение спама, но и индексацию полезных страниц, статусы, canonical и внутренние связи. Такой подход к связанным ограничениям показан в нашем кейсе технического SEO-аудита сайта.
Как проверить результат очистки
Принимайте результат по сохранённым наблюдениям и повторным проверкам. Фраза «сканер больше ничего не находит» полезна только как часть отчёта: владельцу нужно понимать, что именно проверили и как сейчас ведут себя затронутые адреса.
Карточка проверки одного URL
| Поле | Содержание записи |
|---|---|
| URL и источник обнаружения | Полный адрес, параметры, поисковый запрос или отчёт, из которого взят пример |
| Дата и условия | Время с часовым поясом, инструмент, авторизация, устройство и способ перехода |
| Текущий HTTP-ответ | Статус, перенаправления, конечный адрес и сохранённые заголовки |
| Содержимое страницы | HTML, видимый текст, title, canonical и обнаруженные посторонние ссылки |
| Сведения Google | Статус индексации и дата обхода; отдельно дата и результат новой проверки |
| События на сервере | Соответствующие строки журналов, способ проверки робота и связанные изменения |
| Выполненное исправление | Что восстановлено или удалено, какое поведение ожидается для этого адреса |
| Повторная проверка | Дата, фактический результат, приложенные материалы и оставшиеся вопросы |
Признаки завершённой работы
- Для каждого найденного типа подмены установлен источник либо честно указано, каких данных не хватило для вывода.
- Проверены доступы и способы повторного изменения сайта; обнаруженные несанкционированные механизмы устранены.
- Удалённые спамные адреса возвращают ожидаемые статусы, а рабочие страницы сохраняют полезный контент.
- Повторены проверки разных групп URL и условий, при которых раньше проявлялась проблема.
- Внутренние ссылки и карты сайта очищены; проверена выдача после обновления кеша.
- Зафиксированы последующие обращения роботов и изменения сведений Google; старые данные отделены от новых наблюдений.
Результат относится к проверенным адресам, условиям и периоду наблюдения. Запланируйте повторную проверку после новых обходов, а также после событий, с которыми было связано возвращение проблемы: обновлений, публикаций или выполнения заданий по расписанию.
Новые подозрительные URL в отчёте могут оказаться ранее существовавшими, но только сейчас обнаруженными. Проверяйте время и текущий ответ, прежде чем объявлять повторное заражение. Для оценки восстановления следите и за полезными страницами: их видимостью по тематическим запросам, переходами и обращениями посетителей.
Ответы на частые вопросы
Почему сайт выглядит нормально, а Google показывает спам
Возможны выборочная подмена и сохранённые сведения о прежней версии. Сначала сравните один URL в текущем ответе и данных Google с учётом времени. Сам обычный вид главной страницы не отвечает на вопрос о других адресах и условиях выдачи.
Может ли сканер пропустить скрытый SEO-спам
Да. Внешний сканер видит ответы на свои запросы, а файловая проверка охватывает доступные ей файлы и признаки. Если подмена зависит от других условий, находится в базе или промежуточном слое, одной проверки может не хватить.
Значит ли отсутствие страницы в WordPress, что её не существует
Нет. Ответ может формироваться общим обработчиком, настройкой сервера или подключаемым кодом. Проверять нужно реальный URL и путь формирования ответа, а не только список записей в админке.
Чистая проверка опубликованной страницы исключает взлом
Она показывает результат конкретного нового обращения. Сопоставьте его с предыдущими данными, браузером и журналами. Особенно внимательно проверяйте условия, при которых уже удалось увидеть посторонний контент.
Можно ли закрыть спамные страницы через robots.txt
Это ограничит обход, но само по себе не обеспечит удаление из поиска. Сначала устраните источник спама и настройте правильное поведение адресов. Не закрывайте Google доступ к сведениям, которые должны подтвердить исправление.
Что выбрать для мусорного адреса — 404 или 410
Оба статуса подходят для страницы, которой больше не должно быть. Выбирайте ответ по смыслу и устройству сайта. Важнее корректный HTTP-статус и отсутствие повторной генерации, чем ожидание гарантированно более быстрого удаления от одного из кодов.
Сколько времени спам будет исчезать из Google
Универсального срока нет. Проверяйте, был ли адрес переобойдён после исправления, доступен ли новый ответ и не появилась ли подмена снова. Изменения на сервере и обновление выдачи фиксируйте отдельными датами.
Нужно ли удалять весь сайт из Google
Для локального заражения такое действие может затронуть полезные страницы и обращения из поиска. Работайте с установленными группами URL. Решение о более широком ограничении принимают по реальному масштабу и риску инцидента.