Разбираем не очередной «секрет AI-SEO», а товарную архитектуру: какие данные должен уметь отдавать магазин, как устроены SKU и варианты, зачем синхронизировать цену и наличие и почему один качественный источник данных полезнее пяти ручных фидов.
product data layer
ChatGPT Shopping начинается не с нового SEO-тега, а с нормальной товарной базы
ChatGPT постепенно становится ещё одним каналом поиска и сравнения товаров. Пользователь может не вводить точное название модели, а описать задачу обычными словами – бюджет, характеристики, цвет, размер или сценарий использования – и получить подходящие варианты.
Для интернет-магазина это меняет сам принцип товарной видимости. В классическом поиске основным объектом была страница. В AI-shopping всё важнее становится структурированный слой, из которого система может однозначно понять, что продаётся, какой вариант доступен, сколько он стоит и куда вести покупателя.
Поэтому подготовка к ChatGPT Shopping – это в первую очередь работа с каталогом, SKU, вариантами, ценами, остатками и изображениями. Если эти данные хаотичны внутри самого магазина, красивый экспорт проблему не исправит.
Что значит «попасть в ChatGPT Shopping»
Попадание товара в Shopping нельзя свести к одной кнопке. ChatGPT может получать сведения о товарах с публичных страниц магазина, через интеграции торговых платформ и через структурированные товарные данные, которые продавец передаёт в коммерческую инфраструктуру OpenAI.
Карточки товара, категории, изображения и структурированные данные помогают системе обнаруживать ассортимент.
Часть продавцов может подключаться через поддерживаемые торговые платформы и партнёрские каналы.
Структурированный канал даёт продавцу больше контроля над ценой, наличием, вариантами и другими коммерческими данными.
Корректный фид делает товар пригодным для машинного понимания, но сам по себе не гарантирует показ по конкретному запросу. Это инфраструктура данных, а не покупка позиции в выдаче.
Товарный фид становится машинно-читаемой копией магазина
Хороший фид – не таблица, которую однажды выгрузили и забыли. Он должен отражать реальное состояние магазина: конкретный товар, конкретный вариант, текущую цену, наличие, изображение и продавца.
Чем меньше системе приходится «угадывать» по HTML, тем надёжнее она понимает ассортимент. Поэтому товарная база постепенно становится отдельным техническим активом интернет-магазина.

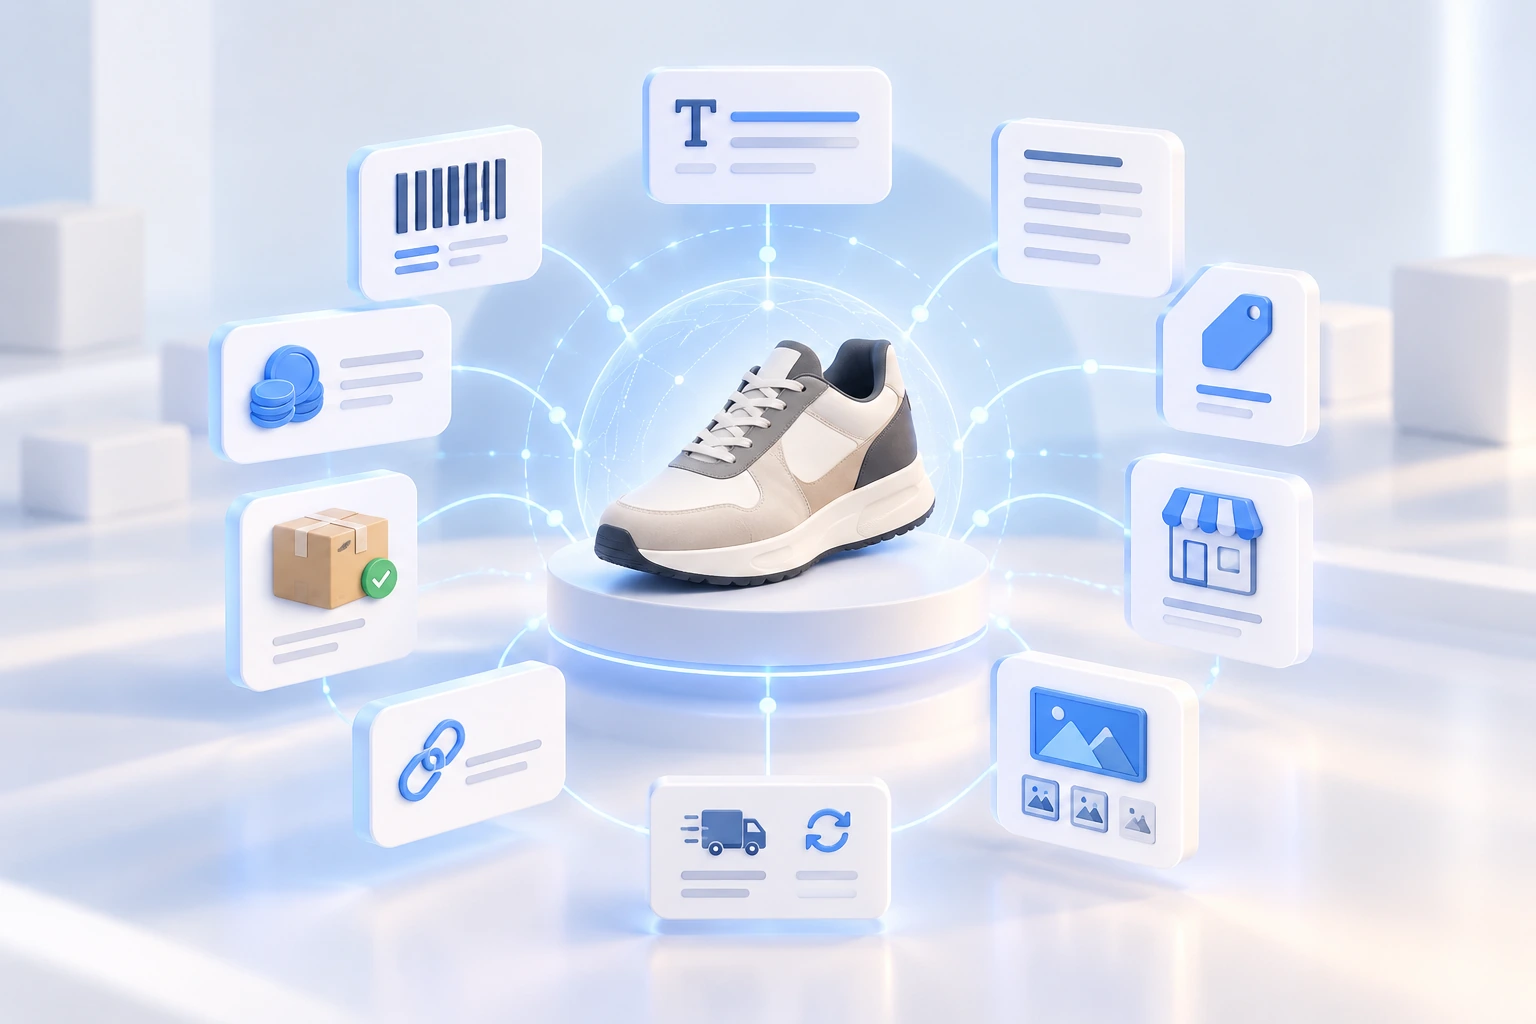
Что система должна уметь понять о каждом товаре
Независимо от конкретной версии спецификации, базовая задача остаётся стабильной: внешний сервис должен получить непротиворечивую коммерческую картину товара.
Какие данные стоит подготовить в первую очередь
Техническая спецификация OpenAI развивается, поэтому перед реальным подключением нужно сверять действующую Stable-версию. Но ядро товарных данных устойчиво: идентификатор, название, описание, URL, бренд, продавец, изображение, наличие и цена.
В текущей файловой схеме этим сущностям соответствуют поля item_id, title, description, url, brand, seller_name, image_url, availability и price.
| Данные | Зачем нужны |
|---|---|
| Идентификатор | Отличить конкретный товар или вариант от остальных. |
| Название и описание | Понять, что именно продаётся и какими свойствами обладает. |
| URL | Отправить пользователя на нужную страницу. |
| Бренд и продавец | Понять производителя и источник предложения. |
| Изображение | Показать именно ту позицию или вариант, который описывается. |
| Наличие | Не показывать недоступный вариант как доступный к покупке. |
| Цена | Передать текущую стоимость предложения. |
Стабильный идентификатор важнее красивого артикула
По идентификатору система должна понимать: это тот же самый объект, который она уже видела раньше, только у него изменилась цена, остаток или изображение. Поэтому ID нельзя генерировать заново при каждом экспорте.
Один товар и один SKU – не всегда одно и то же
Для покупателя футболка может быть одним товаром. Но три цвета и четыре размера дают до двенадцати покупаемых комбинаций – с разными артикулами, остатками, ценами, изображениями или URL.
Практический принцип простой: если покупатель способен отдельно выбрать и купить эту комбинацию, магазин должен уметь отдельно описать её в данных.
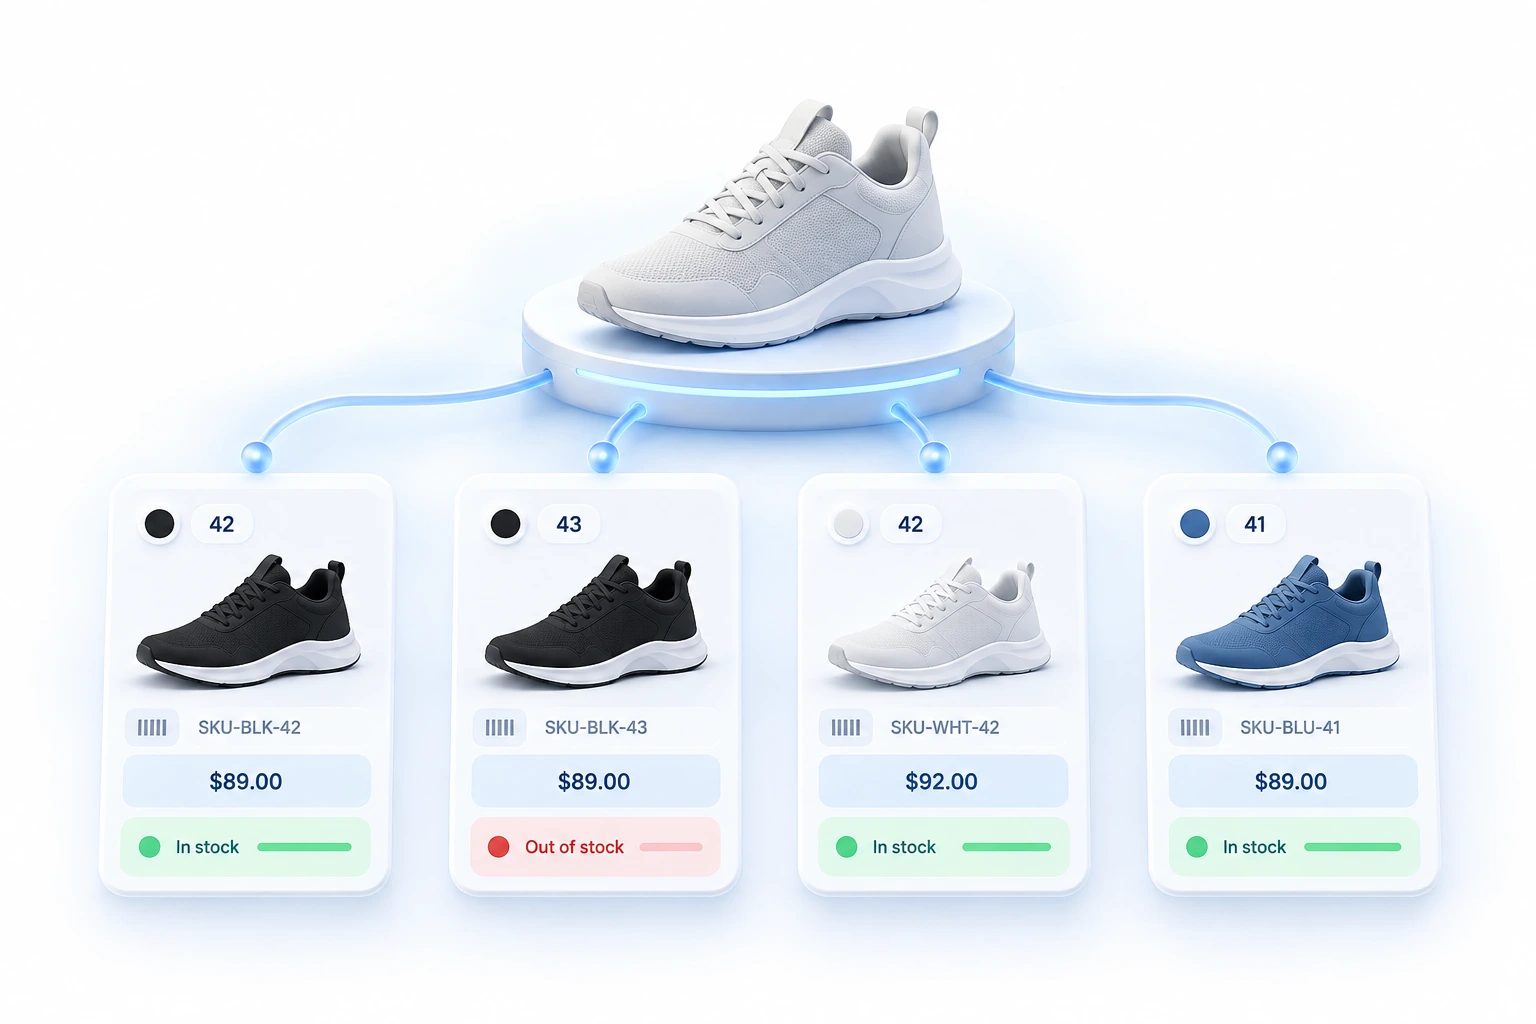
Цена, наличие и изображение должны описывать один и тот же вариант
Красный вариант не должен вести на фотографию синего только потому, что она стоит первой в родительской карточке.
Фид должен получать стоимость из того же источника, который управляет ценой на сайте, а не из отдельной ручной таблицы.
Статус должен отражать реальный остаток конкретной комбинации, а не состояние всей модели целиком.
Чем быстрее меняются цены и остатки, тем опаснее независимый ручной фид. Для крупных магазинов товарная интеграция должна быть продолжением CMS, ERP или складской системы.
GTIN, MPN и другие идентификаторы лучше не придумывать
Если у товара существует реальный GTIN, EAN, UPC или MPN, его стоит сохранять и передавать там, где это поддерживается. Такие идентификаторы помогают сопоставлять одну и ту же товарную единицу между разными источниками.
Но фиктивный код хуже его отсутствия. Особенно важно не путать идентификатор модели с идентификатором конкретного варианта: визуально похожие размеры или комплектации могут быть разными торговыми единицами.
Файл или API – не конкуренты, а два уровня обновления каталога
Для большого ассортимента логично разделять полный снимок каталога и оперативные изменения. Полная выгрузка отвечает на вопрос «что вообще есть в ассортименте», а API – «что изменилось после последнего снимка».
Периодический snapshot всего каталога – товары, варианты, цены, остатки и остальные поля.
Изменение остатка, цены, доступности или другой критичной информации без ожидания следующего полного экспорта.
Сначала строим внутреннюю модель товара, затем отображаем её в нужный файловый или API-формат. Не наоборот.
Файловый фид и API не следует считать одной таблицей в двух форматах
В файле удобно использовать плоскую модель: одна строка – одна покупаемая позиция или вариант. API может быть вложенным: объект товара содержит массив вариантов, а уже у каждого варианта есть собственные цена, наличие и характеристики.
| Принцип | Файловая модель | API-модель |
|---|---|---|
| Единица передачи | Строка варианта | Объект товара + вложенные варианты |
| Идентификаторы | ID конкретной позиции | ID товара и ID варианта |
| Обновления | Удобен для полного снимка | Удобен для точечных изменений |
Поэтому схема «возьмём CSV и просто завернём каждую строку в JSON» может оказаться неверной. Интеграцию нужно строить от модели каталога, а не от случайного экспортного файла.
Коммерческий контекст – не только цена
Можно ли использовать фид Google Merchant Center
Если магазин уже работает с Merchant Center, значительная часть подготовительной работы выполнена: существуют ID, названия, описания, ссылки, изображения, бренды, цены, наличие и группировка вариантов.
Но считать Google-фид и OpenAI-фид одним и тем же форматом нельзя. Даже при наличии совместимого профиля могут отличаться названия полей, допустимые значения, обязательность, способы доставки файла и модель вариантов.
Единый источник товарных данных → отдельный экспорт под Google → отдельный экспорт под OpenAI. Подробное сопоставление полей лучше делать отдельно, чтобы не смешивать две разные интеграции.
Не путайте Shopping-фид и рекламный каталог
Товарные данные помогают системе обнаруживать и представлять предложения в коммерческом поиске и рекомендациях.
Рекламные каталоги используются в платном контуре. Загрузка товара для рекламы не означает автоматического включения в органический Shopping.
По рекламному направлению на VozniNet есть отдельный материал: реклама в ChatGPT. Здесь мы остаёмся в границах подготовки товарного каталога и merchant-интеграции.
Как отслеживать переходы из AI-shopping
URL товаров желательно строить так, чтобы переходы из ChatGPT можно было отличить в аналитике от Google, рекламы, прямого трафика, маркетплейсов и других AI-систем. Для этого можно использовать UTM или собственные стабильные параметры атрибуции.
При этом не стоит оценивать AI-shopping только по последнему клику: пользователь может найти товар через ChatGPT, вернуться позже напрямую или через Google и только потом оформить заказ.
Что реально стоит автоматизировать
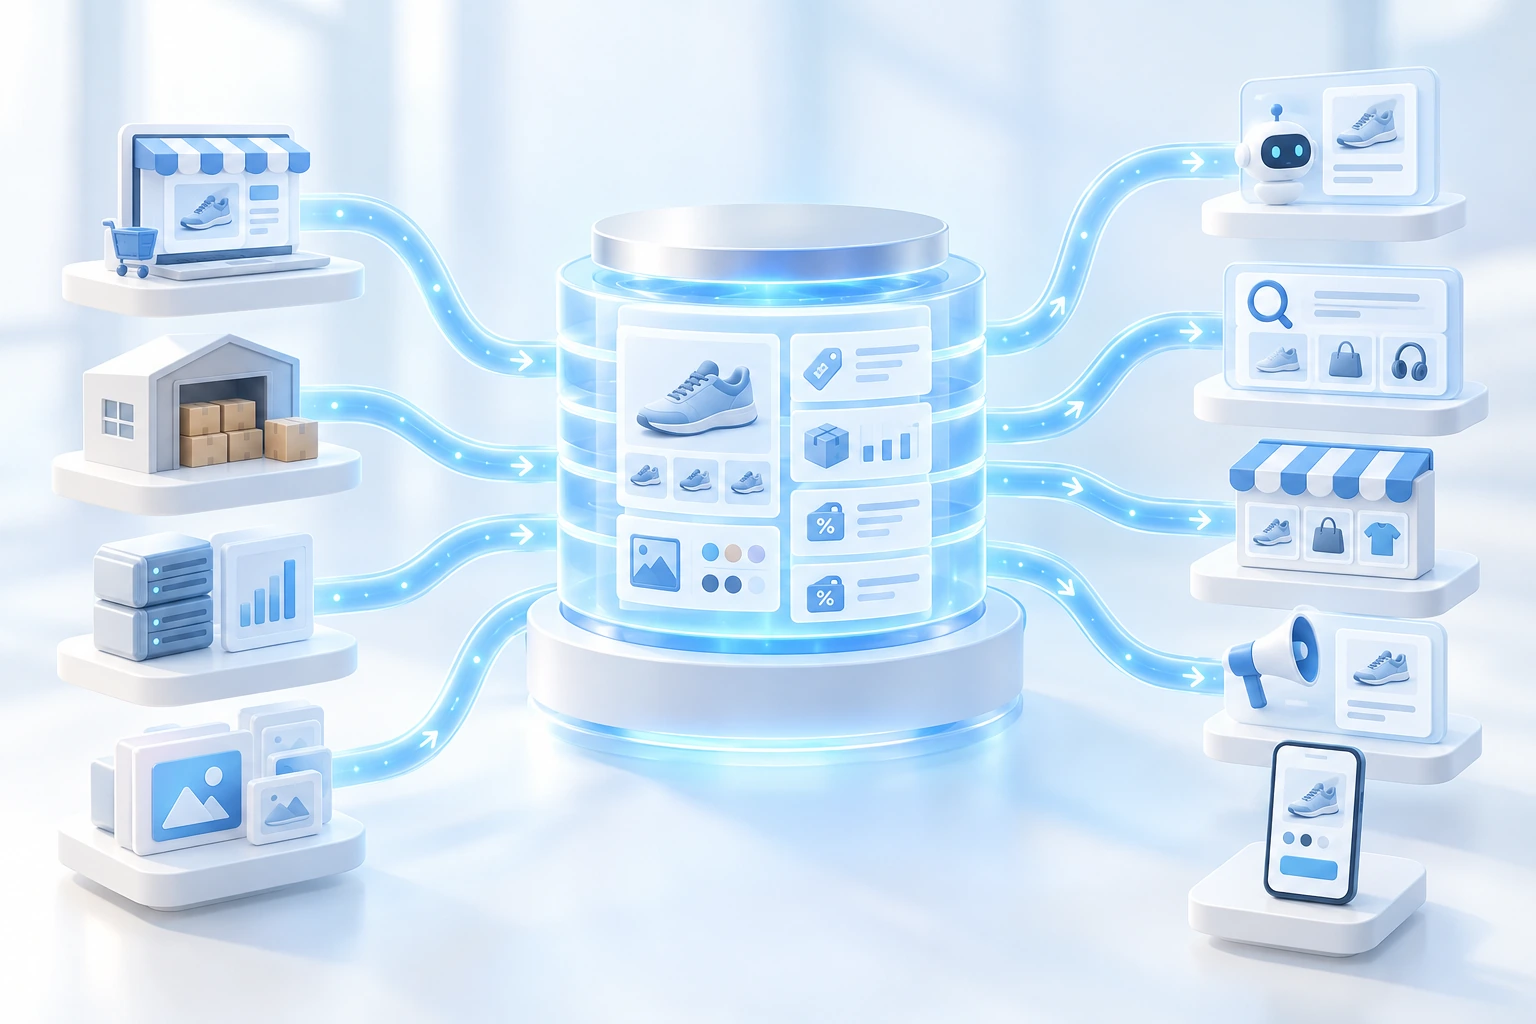
Для каталога из десяти товаров файл ещё можно собрать вручную. Для тысяч SKU это быстро превращается в источник ошибок. Поэтому ChatGPT feed не должен иметь отдельную ручную базу.
Лучше строить один внутренний товарный слой – товар → варианты → атрибуты → цена → остаток → изображения → коммерческие условия – а уже из него формировать разные экспорты.
Сайт, Merchant Center, маркетплейсы, реклама, ChatGPT и будущие AI-платформы должны получать данные из одной логики, а не из пяти независимых таблиц.
Чек-лист готовности интернет-магазина к ChatGPT Shopping
Вместо вопроса «доступен ли Shopping уже в моей стране?» полезнее сначала проверить: если подключение станет доступно завтра, сможет ли магазин без аврала передать нормальный каталог?
Перед подключением проверяйте текущую спецификацию OpenAI
Есть параметры, которые могут меняться быстрее самой товарной архитектуры: география Shopping, порядок merchant onboarding, доступность самостоятельного подключения, текущая Stable-схема, обязательные поля, поддерживаемые способы загрузки и ограничения товарных категорий.
Поэтому непосредственно перед внедрением нужно сверяться с официальной документацией. Эта статья специально построена вокруг устойчивых принципов каталога, а не вокруг списка стран или временного статуса конкретного пилота.
Готовиться нужно не к одной кнопке «Подключить», а к машинному использованию каталога
Товарные платформы движутся в одном направлении: меньше восстановления коммерческих данных по странице – больше прямого структурированного обмена. Google Merchant Center давно работает по этой логике, маркетплейсы живут по ней, рекламные системы используют каталоги, и AI-shopping движется туда же.
Поэтому работа над стабильными SKU, вариантами, изображениями, ценой, остатками и автоматизированным экспортом не становится бесполезной, даже если конкретные правила OpenAI изменятся. Это инвестиция не в один фид – это инвестиция в товарную архитектуру интернет-магазина.
Частые вопросы
Полезно по теме
Не стройте отдельную таблицу ради ChatGPT – стройте нормальную товарную систему
Если каталог уже умеет надёжно отдавать варианты, цены, остатки, изображения и идентификаторы, новая интеграция становится техническим экспортом, а не новым проектом по ручной чистке данных.