ИИ научился читать веб без перехода пользователя. Теперь появляется вопрос: кто заплатит за сам контент?
Классическая экономика поиска была понятной: поисковая система находила страницу, человек переходил на сайт, а владелец получал рекламу, заявку или продажу. AI-поиск меняет эту цепочку. Система может прочитать страницу, извлечь нужные сведения и сформировать готовый ответ – пользователь при этом вообще не обязан посещать источник.
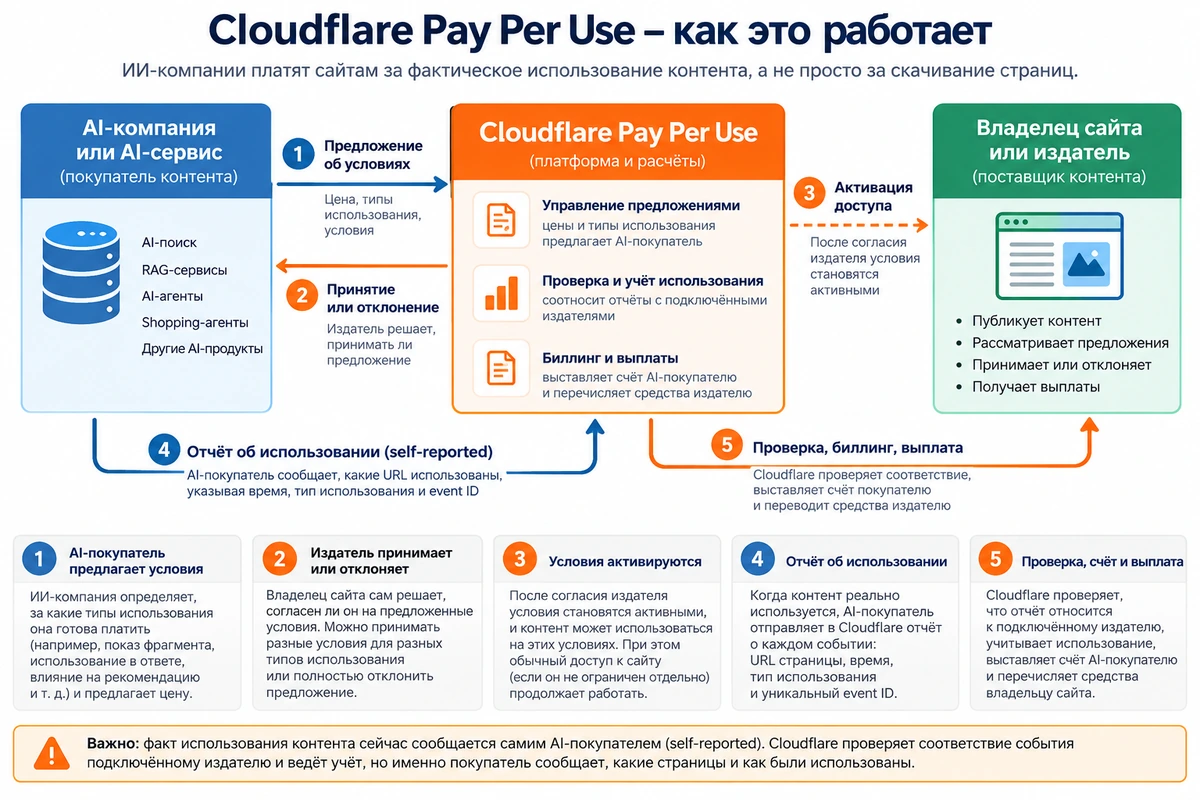
30 сентября 2026 года Cloudflare перевела Pay Per Use в beta. Идея принципиально отличается от привычной оплаты за трафик: AI-покупатель предлагает цену за конкретный способ использования контента, издатель принимает или отклоняет условия, покупатель сообщает о фактах использования, а Cloudflare занимается учётом, биллингом и выплатой.
Платить предлагают не за скачивание страницы, а за фактическое использование её содержания
В модели Pay Per Use покупатель определяет, какой тип использования для него имеет ценность. Это может быть фрагмент материала в AI-поиске, сведения, повлиявшие на рекомендацию, или другой заранее оговорённый сценарий. Для одного и того же материала могут существовать разные условия и разные цены.
Pay Per Crawl и Pay Per Use – похожие названия, но принципиально разные модели
Pay Per Crawl продаёт доступ к странице. Pay Per Use пытается продавать ценность, которую AI получил после доступа. Это различие важно: бот может скачать материал и никогда его не использовать, а одна действительно полезная публикация может участвовать в большом количестве AI-ответов.
| Параметр | Pay Per Crawl | Pay Per Use |
|---|---|---|
| За что платят | За успешное получение страницы | За оговорённое последующее использование |
| Событие | HTTP 200 при доступе crawler’а | Usage event после использования контента |
| Кто задаёт цену | Владелец сайта | AI-покупатель предлагает, издатель принимает или отклоняет |
| Минимальная цена | От $0.001 за crawl | Универсальной публичной ставки нет |
| Статус на 03.10.2026 | Closed beta | Beta |
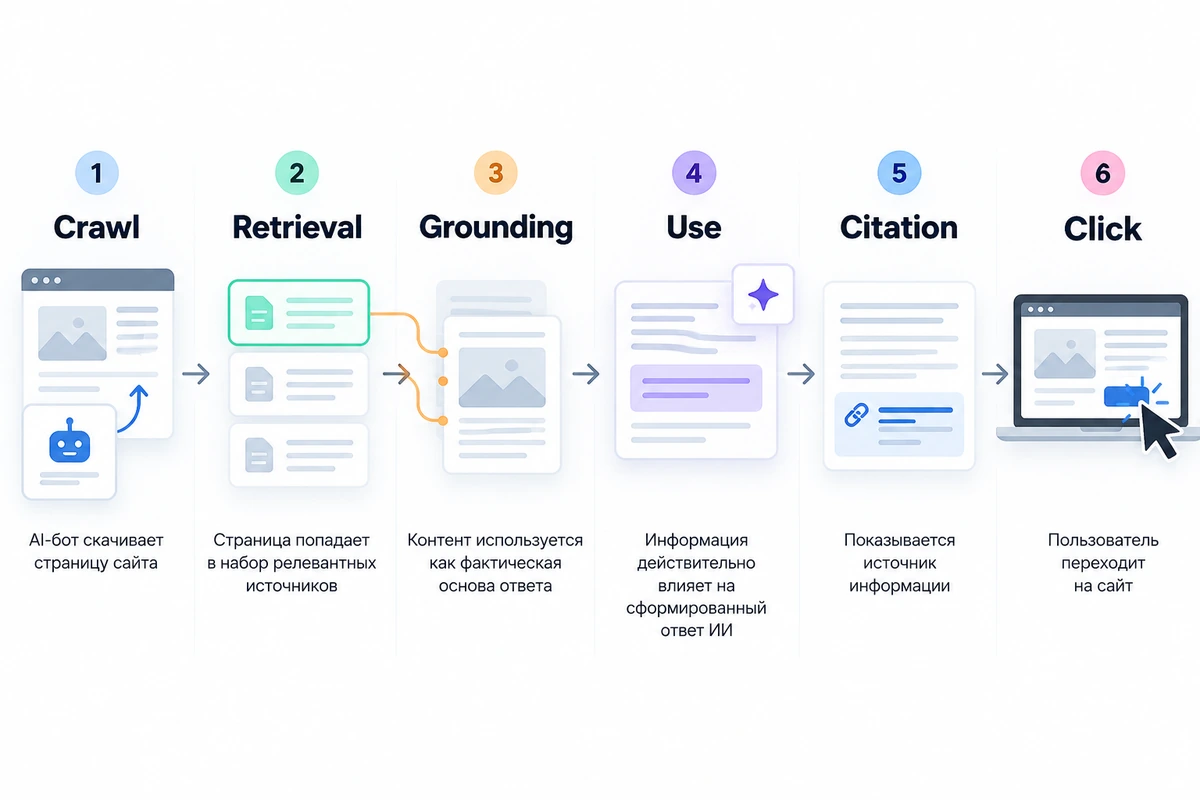
Crawl → Retrieval → Grounding → Use → Citation → Click
Одна из главных ошибок в разговорах о монетизации AI-контента – считать все обращения к странице одинаковыми. Между загрузкой URL ботом и реальным переходом человека есть несколько самостоятельных этапов, и разные компании пытаются поставить денежный счётчик в разных точках этой цепочки.
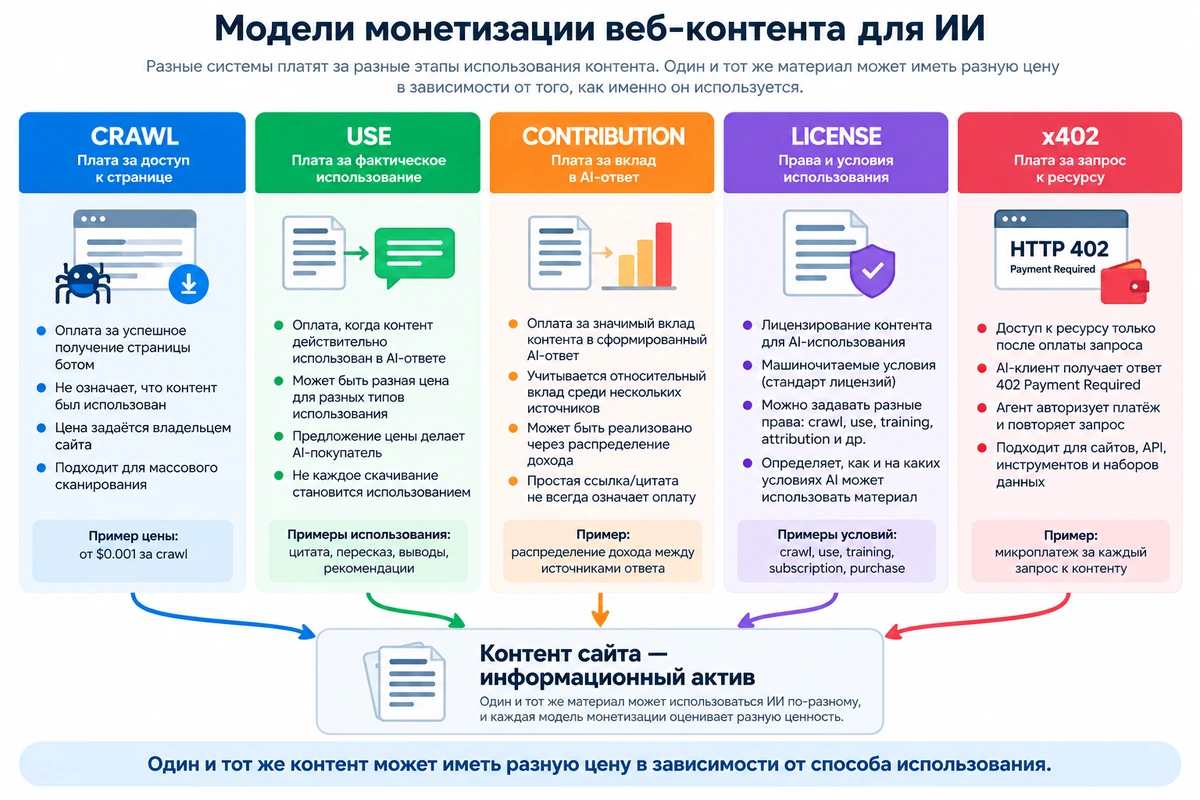
Пять способов превратить веб-контент в оплачиваемый информационный актив
Pay Per Use – только одна модель. Параллельно развиваются оплата за crawl, компенсация за вклад в ответ, лицензирование и машинные платежи прямо внутри HTTP-запроса. Это уже не один продукт, а несколько конкурирующих подходов к новой экономике веба.
Кто платит, за какое событие и как фиксируется использование
| Модель | За что платят | Кто определяет цену | Как фиксируется | Статус |
|---|---|---|---|---|
| Cloudflare Pay Per Crawl | Успешное получение страницы | Владелец сайта | HTTP-доступ | Closed beta |
| Cloudflare Pay Per Use | Фактическое использование | Покупатель предлагает | Self-reported usage event | Beta |
| Google AI Contribution | Значимый вклад в AI-ответ | Не раскрыто | Внутренние метрики Google | Ограниченный pilot |
| Microsoft PCM | Лицензированный grounding | Лицензионная модель | Usage-based reporting | Развиваемая платформа |
| TollBit | Summary / grounding / citation / display | Владелец контента | Учёт по лицензии | Действующая платформа |
| RSL | Crawl / use / training и др. | Владелец задаёт условия | Машиночитаемая лицензия | Открытый стандарт |
| ProRata | Вклад источника в AI-продукт | Revenue share | Собственная атрибуция | Действующая модель |
| Cloudflare x402 | Запрос к ресурсу | Продавец | HTTP 402 + платёж | Closed beta, ограничения |
Проверил серверные логи: AI-системы действительно обращаются к контенту сайта
Чтобы не рассуждать о монетизации AI-контента только теоретически, я проверил access logs VozniNet за сентябрь – начало октября 2026 года. Простого поиска по User-Agent оказалось недостаточно: часть запросов лишь представлялась ботами OpenAI. Поэтому обращения дополнительно сверялись с официально опубликованными IP-диапазонами.
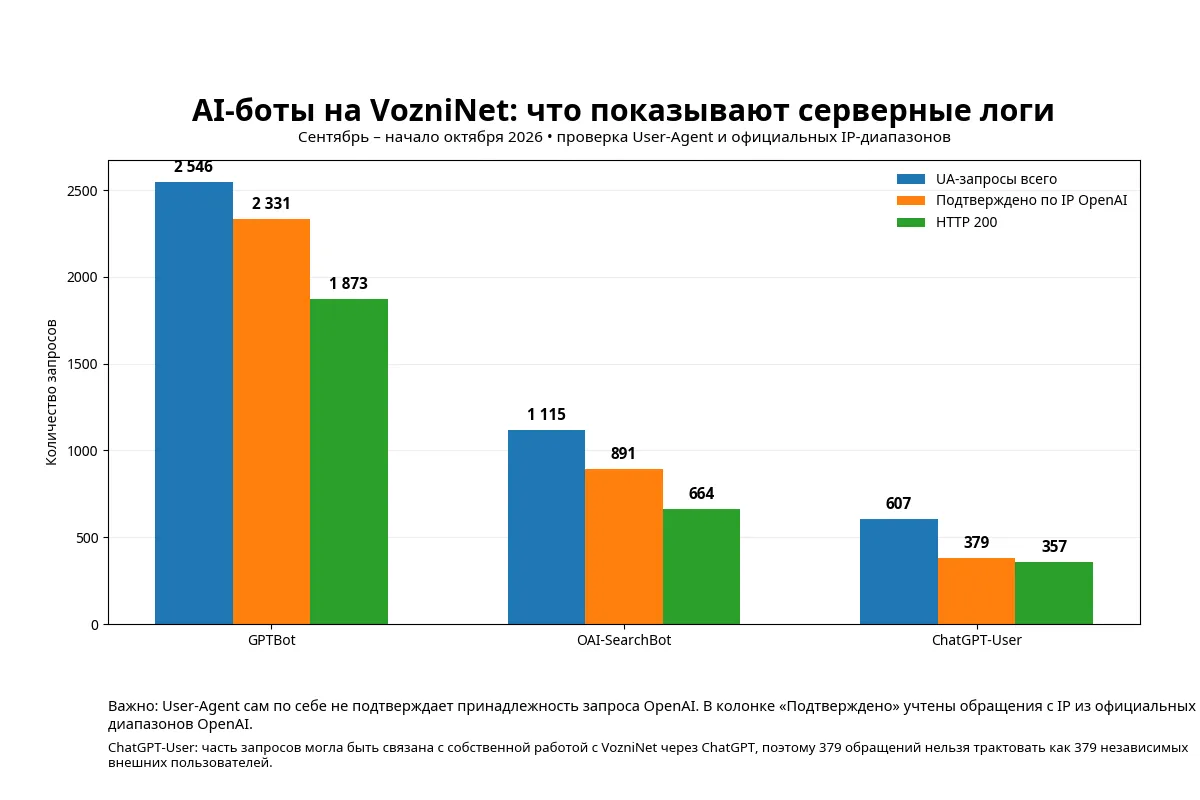
Значит ли наличие GPTBot и OAI-SearchBot, что сайт уже зарабатывает на ИИ?
Нет. Сам факт обращения GPTBot, OAI-SearchBot или ChatGPT-User не создаёт выплат владельцу сайта. У OpenAI эти агенты выполняют разные функции: GPTBot используется для обхода контента, который может применяться при развитии foundation models; OAI-SearchBot отвечает за поиск и появление сайтов в поисковых функциях ChatGPT; ChatGPT-User может обращаться к странице в результате определённых действий пользователя и не является автоматическим crawler’ом.
Что владельцу сайта имеет смысл делать уже сейчас
Скорее всего, единой модели «ИИ платит сайту» не будет
У разных способов использования разная экономика. Crawl подходит для массового получения страниц. Use – для AI search, RAG и ответов. Contribution – для распределения стоимости между несколькими источниками. x402 – для API, datasets и agent tools. Машиночитаемые лицензии нужны, чтобы заранее сообщать права и условия.
Главное о заработке сайта на AI-контенте
Можно ли уже подключить VozniNet к Cloudflare Pay Per Use и получать деньги?
Наличие Pay Per Use beta ещё не означает универсальную доступность и гарантированный доход для любого сайта. Нужно отдельно проверять доступность программы, условия участия и наличие AI-покупателей, готовых платить именно за этот контент.
OpenAI платит за обращения GPTBot?
Сам по себе запрос GPTBot не является платёжным событием. В официальном описании OpenAI GPTBot указан как crawler для контента, который может использоваться при развитии foundation models; автоматической оплаты владельцу сайта за каждый такой запрос не заявлено.
Стоит ли блокировать AI-ботов, пока они не платят?
Единого ответа нет. Например, блокировка OAI-SearchBot противоречит цели присутствовать в поисковых результатах ChatGPT. Доступ к поисковым, training- и другим AI-ботам лучше оценивать отдельно с учётом задач сайта.
Что ценнее: crawl, citation или contribution?
Это разные события. Crawl измеряет доступ, citation – видимое указание источника, contribution – влияние материала на формирование ответа. Какая единица станет основной для оплаты, рынок пока не решил.
Почему нельзя просто посчитать AI-ботов в access log и умножить на цену?
Потому что User-Agent можно подделать, а получение страницы не означает её дальнейшее использование. Для расчёта нужны как минимум верификация агента и понятное платёжное событие, которое признают обе стороны.
Нужно понять, какие AI-боты реально ходят на ваш сайт и какой контент они забирают?
Можно начать с серверных логов, robots.txt, структуры контента и текущей поисковой видимости – без догадок по одному User-Agent.